



Reverse Engineering ist das Zerlegen eines fertigen Erzeugnisses, um zu verstehen, wie es gebaut ist. In der Software heißt das, aus einem lauffähigen Programm zurückzuschließen, was sein Quelltext tat.
- Reverse Engineering
Das Zerlegen eines fertigen Erzeugnisses, um zu verstehen, wie es gebaut ist.
Beispiel: „Das Reverse Engineering der Schadsoftware ergab, an welche Adresse sie ihre Beute schickte.“Auch: Nachkonstruktion, Rückentwicklung. Der Schritt vom Maschinencode zurück zu lesbarem Code heißt Dekompilieren, der zum reinen Befehlstext Disassemblieren.
Abgrenzung zum Nachbauen: Das Verstehen ist der erste Schritt. Ob das Ergebnis danach benutzt werden darf, ist eine eigene Frage, siehe unten.
Was beim Übersetzen verloren geht
Alles, was der Rechner nicht braucht. Beim Übersetzen fallen die Namen von Funktionen und Variablen weg, die Kommentare, die Typen und die gewählte Form der Verzweigung; übrig bleibt eine Folge von Befehlen auf Registern. Ein Dekompiler gewinnt daraus die Struktur zurück und vergibt eigene Namen, die mit den ursprünglichen nichts zu tun haben.
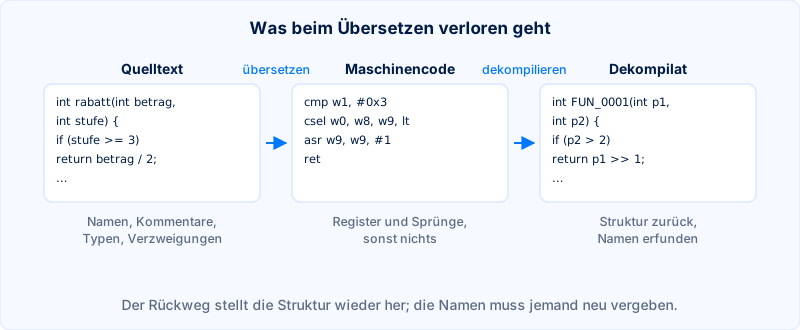
Deshalb ist Reverse Engineering kein Zurückdrehen, sondern eine Rekonstruktion mit Lücken. Wie groß die Lücken sind, hängt davon ab, wie stark der Übersetzer optimiert hat und ob jemand zusätzlich Mühe darauf verwendet hat, das Lesen zu erschweren.
Was der Übersetzer aus drei Zeilen macht
Ein Beispiel, das sich nachvollziehen lässt. Die folgende Funktion gibt je nach Stufe einen Rabatt zurück.
// Die Funktion, wie jemand sie geschrieben hat
int rabatt(int betrag, int stufe) {
    if (stufe >= 3) return betrag / 2;
    if (stufe == 2) return betrag - betrag / 4;
    return betrag;
}
Nach dem Übersetzen mit eingeschalteter Optimierung sieht dieselbe Funktion so aus. Die Ausgabe stammt aus einem echten Lauf auf einem ARM64-Rechner.
# Dieselbe Funktion nach `cc -O2`, gelesen mit `objdump -d`
add  w8, w0, #0x3
cmp  w0, #0x0
csel w8, w8, w0, lt
sub  w8, w0, w8, asr #2
cmp  w1, #0x2
csel w8, w0, w8, ne
add  w9, w0, w0, lsr #31
asr  w9, w9, #1
cmp  w1, #0x3
csel w0, w8, w9, lt
ret
Drei Dinge sind passiert. Die Namen sind weg. Aus den Verzweigungen ist verzweigungsfreier Code geworden: csel wählt zwischen zwei Werten, ohne zu springen. Und die Divisionen durch zwei und vier sind zu Schiebeoperationen geworden. Wer das zurücklesen will, muss diese Umformungen kennen, und genau das ist die Arbeit.
Die vier Werkzeuge
Sie beantworten verschiedene Fragen und werden nebeneinander benutzt.
Werkzeug | Was es tut | Was es nicht leistet |
|---|---|---|
Disassembler | Übersetzt Maschinencode in lesbare Befehle | Keine Struktur, keine Namen |
Dekompiler | Baut daraus wieder Quelltext-ähnlichen Code | Die Namen sind erfunden, der Code oft nicht übersetzbar |
Debugger | Hält das laufende Programm an und zeigt den Zustand | Braucht eine Umgebung, in der es laufen darf |
Emulator | Führt den Code in einer nachgebauten Umgebung aus | Schadsoftware erkennt die Umgebung oft |
In der Praxis beginnt eine Untersuchung statisch, also ohne das Programm auszuführen, und geht erst zum Ausführen über, sobald klar ist, worauf zu achten ist. Bei Schadsoftware ist die Reihenfolge Pflicht: Was man nicht verstanden hat, startet man nicht.
Was KI-Agenten daran geändert haben
Sie bedienen die Werkzeuge selbst. Seit 2025 verbreitet sich ein Muster, bei dem ein Sprachmodell einen laufenden Disassembler über eine Schnittstelle steuert: Es lässt sich die Funktionen auflisten, folgt Querverweisen, benennt Variablen um und schreibt seine Einschätzung in die Datenbank des Werkzeugs. Der Mensch gibt die Richtung vor und prüft; die mechanische Arbeit läuft nebenher.
Der Gewinn liegt weniger im Dekompilieren selbst als im Benennen und Einordnen. Ein Modell erkennt an der Form einer Funktion, dass sie eine Prüfsumme bildet, eine Konfiguration einliest oder eine Verbindung aufbaut, und schlägt dafür Namen vor. Was früher Stunden des Durchlesens kostete, ist damit eine Frage von Minuten, und der Mensch beginnt nicht mehr bei FUN_0001.
Wo KI beim Reverse Engineering scheitert
An der Genauigkeit, und der Befund ist belegt. Eine Untersuchung vom 04.09.2026 hat gemessen, was passiert, wenn ein Sprachmodell die Ausgabe eines Dekompilers aufräumt: Der Anteil des Codes, der sich wieder übersetzen lässt, steigt von 75 auf 90 Prozent. Der Anteil, der sich danach noch wie das Original verhält, fällt von 74 auf 62 Prozent.
Das ist die unangenehme Pointe. Das Ergebnis sieht besser aus und ist schlechter. Dieselbe Untersuchung fand, dass knapp fünf Prozent der Ausgaben alle mitgelieferten Tests bestehen und sich trotzdem anders verhalten als das Original; bei einem einzelnen System waren es dreizehn Prozent. Und bei Programmen mit bekannter Schwachstelle verschwand in bis zu einem Zehntel der Fälle der Absturz, den die Lücke auslöst.
Für die Praxis heißt das: Ein aufgeräumtes Dekompilat ist eine Lesehilfe und kein Beweis. Wer daraus einen Befund ableitet, prüft ihn am Original, nicht am Text des Modells. Das ist dieselbe Vorsicht, die bei jeder Halluzination angebracht ist, nur dass sie hier schwerer auffällt, weil der erzeugte Code plausibel aussieht.
Wie weit die automatische Schwachstellensuche ist
Weiter, als die meisten vermuten, und immer noch nicht weit genug. Die Forschungsbehörde des US-Verteidigungsministeriums hat dazu einen Wettbewerb ausgeschrieben, dessen Finale im August 2025 stattfand: Sieben Systeme sollten in offener Software selbständig Lücken finden und beheben, ohne dass ein Mensch eingreift.
Die Zahlen aus der Auswertung: Von 63 eingebauten Schwachstellen fanden die Systeme 54, also 86 Prozent, und behoben 43, also 68 Prozent. Nebenbei entdeckten sie 18 echte, bis dahin unbekannte Lücken in den untersuchten Programmen, sechs davon in C- und zwölf in Java-Code, und lieferten dafür elf Korrekturen. Den ersten Platz belegte ein Verbund aus einem Konzern und drei Hochschulen.
Daraus folgt für die eigene Lage zweierlei. Erstens: Was ein solches System findet, findet es auch für die Gegenseite, und die Werkzeuge sind veröffentlicht. Zweitens: Ein Drittel der eingebauten Lücken blieb ungefunden, und für die gefundenen war der Patch nicht immer brauchbar. Automatische Prüfung verschiebt die Messlatte und ersetzt weder den Penetrationstest noch das Patch-Management.
Wofür Reverse Engineering gebraucht wird
Für vier Dinge, von denen nur eines nach Angriff klingt. Die Untersuchung von Schadsoftware, um zu verstehen, was sie tut und woran man sie erkennt. Die Herstellung von Interoperabilität, wenn ein Hersteller seine Schnittstelle nicht dokumentiert. Die Pflege von Altsystemen, deren Quelltext niemand mehr hat. Und die Prüfung eingekaufter Software auf das, was nicht im Datenblatt steht.
Was rechtlich erlaubt ist
In Europa mehr, als viele annehmen. Nach Paragraf 69d Absatz 3 des Urheberrechtsgesetzes darf, wer ein Programm benutzen darf, dessen Funktionsweise beobachten, untersuchen und testen, um die zugrunde liegenden Ideen zu ermitteln. Paragraf 69e erlaubt darüber hinaus das Rückübersetzen des Codes, wenn das zur Herstellung der Interoperabilität mit einem eigenen Programm unerlässlich ist, die nötigen Angaben nicht anders zu bekommen sind und sich der Eingriff auf die erforderlichen Teile beschränkt.
Zwei Einschränkungen gehören dazu. Das Ergebnis darf nur für diesen Zweck benutzt werden und nicht dafür, ein konkurrierendes Programm mit ähnlichem Ausdruck zu bauen. Und Nutzungsbedingungen, die jemand beim Kauf bestätigt, gelten daneben vertraglich, auch wenn sie mehr verbieten als das Gesetz.
Nachzulesen sind die beiden Regeln in Paragraf 69e UrhG und im Paragrafen davor. In den Vereinigten Staaten ist die Lage unklarer; der Oberste Gerichtshof entschied am 05.04.2021 über einen Einzelfall und ließ die Grundsatzfrage offen.
Was Reverse Engineering nicht leistet
Es liefert nicht den Quelltext zurück. Was dabei entsteht, ist ein Text, der sich ähnlich verhält, und ob er sich wirklich gleich verhält, ist eine eigene Frage, die die Untersuchung von 2026 unangenehm beantwortet hat. Für eine Weiterentwicklung taugt das Ergebnis selten; für das Verstehen fast immer.
Zweitens erklärt es nicht die Absicht. Aus dem Code lässt sich ablesen, was ein Programm tut, nicht warum jemand es so gebaut hat; wer daraus Motive herausliest, verlässt den Befund. Und drittens hat es ein Ende: Ein Programm, das Teile erst zur Laufzeit entschlüsselt oder nachlädt, gibt statisch nichts preis.
Was die Gegenseite dagegen tut
Sie macht das Lesen teuer. Verschleierung benennt Funktionen um, fügt sinnlose Abzweigungen ein, verpackt den eigentlichen Code und entschlüsselt ihn erst beim Start; dazu kommen Prüfungen, ob ein Debugger läuft oder die Umgebung nachgebaut ist. Keine dieser Maßnahmen verhindert das Verstehen, alle verteuern es.
Durch die KI-Werkzeuge hat sich das Verhältnis verschoben, und zwar in beide Richtungen. Modelle sind gut darin, Muster in verschleiertem Code wiederzuerkennen und sinnlose Abzweigungen zu ignorieren; zugleich lässt sich Verschleierung mit denselben Werkzeugen billiger erzeugen als früher. Wer auf Verschleierung setzt, sollte sie deshalb als Zeitgewinn verstehen und nicht als Schutz.
Ein verdächtiges Programm einschätzen, ohne es zu starten
In drei Schritten, die ohne Spezialwerkzeug auskommen. Zuerst den Prüfwert der Datei bilden und bei einem der Sammeldienste nachsehen, ob sie bekannt ist. Dann die Zeichenketten im Programm auslesen; Adressen, Dateipfade und Fehlermeldungen verraten oft schon den Zweck. Erst danach, wenn überhaupt, in eine abgetrennte Umgebung damit, siehe Sandboxing.
Für den Betrieb gilt dabei dieselbe Regel wie bei jedem Fund: Die Untersuchung findet auf einem Gerät statt, das nichts anderes zu verlieren hat, und in einem Netz, das vom Rest getrennt ist. Wer eine verdächtige Datei auf dem Arbeitsrechner öffnet, hat die Entscheidung schon getroffen.
Eine undokumentierte Schnittstelle verstehen
Über den Verkehr, nicht über den Code. Bei einer Anwendung, die mit einem Server spricht, ist der kürzere Weg fast immer die Beobachtung: Welche Adressen werden aufgerufen, welche Angaben gehen mit, wie sieht die Antwort aus? Dafür genügt ein Werkzeug, das den Verkehr mitschneidet, und die Erlaubnis, das eigene Gerät zu untersuchen.
Erst wenn der Verkehr verschlüsselt ist und sich nicht aufbrechen lässt, führt der Weg in das Programm selbst. Dann greift die Regel aus Paragraf 69e, und dann lohnt sich der Blick in die Werkzeuge mit KI-Unterstützung: Die Frage „welche Funktion baut hier die Anfrage zusammen?“ ist genau die, bei der ein Modell heute schnell ist.
Woher der Begriff kommt
Aus der Industrie und nicht aus der Software. Gemeint war ursprünglich das Auseinandernehmen eines fremden Erzeugnisses, um seine Konstruktion zu verstehen; Maschinen, Bauteile, Werkstoffe. Die Übertragung auf Programme kam später, und die biologische Variante, also das Rückschließen von einer Wirkung auf einen Mechanismus, ist heute ein eigenes Feld.
Das erklärt eine Eigenheit des Begriffs: Er trägt keine Wertung. Ob das Zerlegen erlaubt, geboten oder verboten ist, entscheidet sich am Gegenstand und am Zweck, nie am Wort selbst.