



Temperature ist der Wert, der festlegt, wie weit ein Sprachmodell von der wahrscheinlichsten Fortsetzung abweichen darf. Das Modell berechnet für jedes nächste Token eine Wahrscheinlichkeit; die Temperature entscheidet, wie stark die Auswahl an dieser Rangfolge klebt. Übliche Werte liegen zwischen 0 und 2.
- Temperature (KI)
Der Wert, der festlegt, wie weit ein Modell von der wahrscheinlichsten Fortsetzung abweichen darf.
Beispiel: „Für die Auswertung von Formulardaten steht die Temperature auf 0, für Überschriftenvorschläge auf 1.“Verwandter Regler: Top-p begrenzt die Auswahl auf die wahrscheinlichsten Fortsetzungen, bis deren Wahrscheinlichkeiten eine Schwelle erreichen. Die Dokumentationen raten dazu, an einem von beiden zu drehen und den anderen in Ruhe zu lassen.
Der Name führt in die Irre: In manchen Oberflächen heißt der Regler „Kreativität“. Ein hoher Wert erzeugt aber Abwechslung und keine besseren Einfälle. Was danebenliegt, liegt abwechslungsreicher daneben.
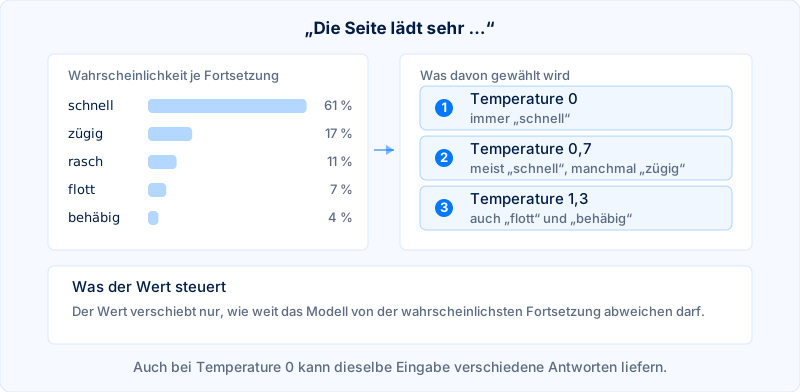
Welcher Wert wofür taugt
Niedrige Werte für alles, was reproduzierbar sein soll: Daten aus Texten ziehen, einordnen, übersetzen, Code erzeugen, nach festem Schema zusammenfassen. Höhere Werte dort, wo mehrere Varianten zur Auswahl stehen sollen, etwa bei Vorschlägen für Überschriften oder Betreffzeilen. Welches Token am Ende gewählt wird, entscheidet das Modell dann in dem Rahmen, den der Wert aufspannt.
Warum 0 keine festen Ergebnisse liefert
Weil die Temperature nur einen von mehreren Gründen für Abweichungen abschaltet.
Anthropic hält im Glossar der Entwicklerdokumentation ausdrücklich fest, dass identische Eingaben auch bei Temperature 0 verschiedene Ausgaben liefern können. Wer gleiche Antworten braucht, speichert die erste und fragt nicht erneut.
Wo der Regler im Alltag sitzt
In den Chat-Oberflächen fast nirgends, in den Schnittstellen und Baukästen überall. Wer über ein Werkzeug mit eigenen Modellen arbeitet, findet ihn in den Einstellungen des Modells; wer über die Schnittstelle programmiert, setzt ihn je Anfrage. In unseren eigenen Abläufen steht er überall dort auf 0, wo das Ergebnis weiterverarbeitet wird, weil jede Streuung an dieser Stelle Nacharbeit erzeugt.