



Nucleus Sampling ist das Verfahren, mit dem ein Sprachmodell entscheidet, welches Token es als Nächstes ausgibt. Zugelassen werden nur die wahrscheinlichsten Fortsetzungen, bis deren Anteil zusammen eine festgelegte Schwelle erreicht. Der Parameter heißt Top-p, und die Schwelle ist genau dieses p. Alles darunter fällt weg, bevor überhaupt gewählt wird.
- Nucleus Sampling (Top-p)
Das Verfahren, mit dem ein Sprachmodell das nächste Token auswählt, begrenzt auf die wahrscheinlichsten Fortsetzungen.
Beispiel: „Bei Top-p 0,9 bleiben an einer eindeutigen Stelle zwei Wörter übrig, an einer offenen zwanzig.“Abgrenzung zu Temperature: Die Temperature verformt die Wahrscheinlichkeiten, Top-p schneidet den Rand ab. Die Dokumentationen raten dazu, an einem von beiden zu drehen und den anderen in Ruhe zu lassen.
Abgrenzung zu Top-k: Top-k lässt immer dieselbe Anzahl Kandidaten zu, etwa die besten vierzig. Top-p passt die Anzahl der Lage an, weshalb es dem Begriff Kern seinen Namen verdankt.
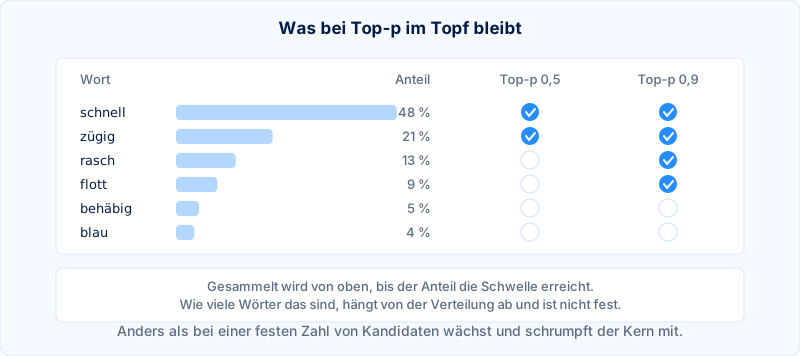
Wie der Kern bestimmt wird
Von oben nach unten. Die möglichen Fortsetzungen werden nach Wahrscheinlichkeit sortiert und aufaddiert, bis die Summe die Schwelle erreicht. Was bis dahin dabei war, bildet den Kern; gewählt wird nur noch daraus. An einer Stelle mit einer klaren Fortsetzung bleiben so zwei Kandidaten übrig, an einer offenen Stelle dreißig.
Woher das Verfahren stammt
Aus einer Arbeit, die ein konkretes Ärgernis beheben wollte.
Holtzman und Kollegen stellten Nucleus Sampling 2019 in The Curious Case of Neural Text Degeneration vor. Der Anlass: Wer immer die wahrscheinlichste Fortsetzung wählt, bekommt Text, der fade und eigentümlich wiederholend gerät. Das Verfahren zieht stattdessen aus dem beweglichen Kern der Verteilung und lässt deren unzuverlässigen Rand weg.
Welcher Wert wofür
Die Voreinstellung liegt bei den meisten Anbietern von Sprachmodellen zwischen 0,9 und 1,0 und passt für fast alles. Niedrigere Werte um 0,5 engen die Auswahl spürbar ein und eignen sich dort, wo Abweichungen stören. Werte unter 0,3 führen zu derselben Eintönigkeit, gegen die das Verfahren ursprünglich antrat.