



Quantisierung verkleinert ein KI-Modell, indem seine gelernten Gewichte mit weniger Stellen gespeichert werden. Aus einer Kommazahl mit 32 Bit wird eine ganze Zahl mit 8 oder 4 Bit. Das Modell bleibt dasselbe, nur gröber aufgeschrieben.
- Quantisierung
Das Verkleinern eines KI-Modells, indem seine Gewichte mit weniger Stellen gespeichert werden.
Beispiel: „Nach der Quantisierung auf 4 Bit passt das Modell auf eine einzelne Grafikkarte.“Wo sie ansetzt: bei der Parameteranzahl ändert sich nichts, nur am Platz je Parameter. Ein Modell mit acht Milliarden Parametern bleibt eines, braucht aber ein Viertel des Speichers.
Abgrenzung zur Destillation: Dort wird ein kleineres Modell darauf trainiert, ein größeres nachzuahmen, und hat danach wirklich weniger Parameter. Die Quantisierung lässt die Zahl der Parameter unberührt.
Was sie bringt
Platz, Tempo und Strom.
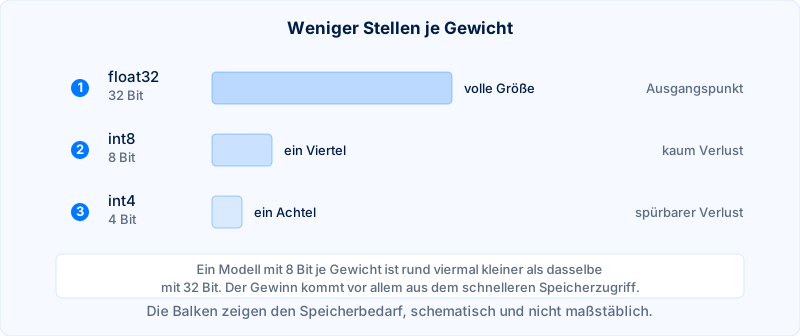
Die Dokumentation von Hugging Face beziffert den Gewinn: Ein Modell mit 8 Bit je Gewicht ist rund viermal kleiner als dasselbe mit 32 Bit, mit 4 Bit noch einmal halb so groß. Der Geschwindigkeitsgewinn kommt dabei vor allem aus der geringeren Speicherbandbreite, nicht aus schnellerer Rechnung.
Was sie kostet
Genauigkeit, und zwar nicht gleichmäßig. Dieselbe Quelle nennt den Handel zwischen Sparsamkeit und Treffsicherheit als die eigentliche Abwägung. Auf 8 Bit ist der Verlust meist kaum zu bemerken, auf 4 Bit deutlich, und er zeigt sich zuerst bei den schwierigen Fällen, nicht bei den einfachen.
Wann sie sich lohnt
Wenn ein Open-Weight-Modell sonst nicht auf die vorhandene Hardware passt. Dann lautet die Frage, ob ein kleineres Modell in voller Genauigkeit das bessere Geschäft wäre. Gemessen wird das an den eigenen Fällen und nicht an Ranglisten.
Für eingekaufte Modelle stellt sich die Frage gar nicht. Was ein Anbieter hinter seiner Schnittstelle an Quantisierung einsetzt, steht in keiner Beschreibung, und abgerechnet wird ohnehin nach Token. Der Begriff begegnet einem deshalb fast nur dort, wo Modelle selbst betrieben werden.