



Fine-Tuning ist das Weitertrainieren eines fertigen Modells mit eigenen Beispielen. Das Modell bleibt dasselbe, seine Gewichte ändern sich: Es übernimmt Form, Tonfall und Verhalten aus den Beispielen, die man ihm vorlegt.
- Fine-Tuning (KI)
Das Weitertrainieren eines fertigen Modells mit eigenen Beispielen.
Beispiel: „Nach dem Fine-Tuning mit 800 freigegebenen Antworten trifft das Modell den Ton des Supports.“Sparsame Variante: LoRA trainiert nur wenige zusätzliche Gewichte statt des ganzen Modells. Das senkt Rechenzeit und Speicherbedarf so weit, dass ein Durchlauf auf einer einzelnen Grafikkarte möglich wird.
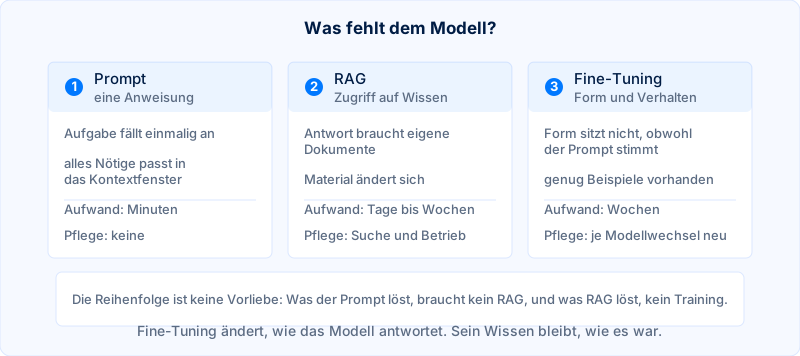
Abgrenzung: Fine-Tuning ändert, wie ein Modell antwortet. Was es über den eigenen Betrieb weiß, ändert es kaum. Dafür ist RAG das Mittel.
Wann es sich lohnt
Wenn die Form nicht sitzt, obwohl der Prompt stimmt. Ein Modell, das nach zehn Anläufen immer noch im falschen Register schreibt oder ein eigenes Ausgabeformat nicht einhält, lernt beides aus Beispielen schneller als aus Anweisungen. Voraussetzung sind genug freigegebene Beispiele, üblicherweise einige hundert.
Anthropic beschreibt Fine-Tuning im Glossar der Entwicklerdokumentation als das Weitertrainieren eines vortrainierten Sprachmodells mit zusätzlichen Daten. Die Betonung liegt auf „zusätzlich“: Das Vorwissen des Modells bleibt erhalten, es kommt etwas obendrauf.
Was es kostet
Mehr als die Rechenzeit. Der Aufwand steckt im Zusammenstellen und Freigeben der Beispiele, und er fällt bei jedem Modellwechsel erneut an: Ein auf eine Modellversion trainierter Stand lässt sich auf die nächste nicht übertragen. Wer alle paar Monate das Modell wechselt, trainiert entsprechend oft nach.
Warum die meisten Fälle keins brauchen
Weil die Lücke selten bei der Form liegt. In unseren Projekten ist der Wunsch nach einem eigenen Modell fast immer der Wunsch nach eigenen Inhalten in der Antwort, und den erfüllt RAG schneller, billiger und mit prüfbaren Quellen. Fine-Tuning bleibt für die Fälle, in denen Prompt und Suche ausgereizt sind.