



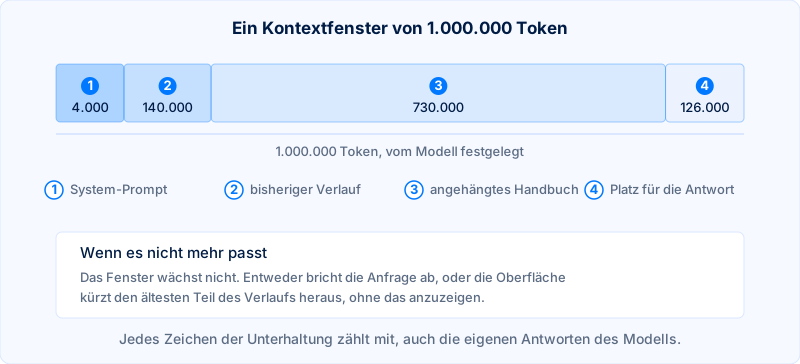
Das Kontextfenster ist die Textmenge, die ein Sprachmodell bei einer Anfrage gleichzeitig vor sich hat, gemessen in Token. Dazu zählt alles: der System-Prompt, die aktuelle Frage, jede frühere Nachricht des Gesprächs, angehängte Dateien und der Platz, den die Antwort selbst braucht. Die Fenster sind in kurzer Zeit stark gewachsen; eine Million Token ist bei den aktuellen Modellen der Normalfall.
- Kontextfenster
Die Textmenge in Token, die ein Sprachmodell bei einer Anfrage gleichzeitig verarbeitet.
Beispiel: „Das Modell hat ein Kontextfenster von einer Million Token, das angehängte Handbuch belegt davon 730.000.“Größenordnung: Die aktuellen Claude-Modelle führen eine Million Token, und Anthropic rechnet das mit rund 555.000 Wörtern um. Für deutsche Texte sind es weniger, weil deutsche Wörter in mehr Token zerfallen. Kleinere Fenster von 128.000 oder 200.000 Token gibt es weiterhin, vor allem bei günstigeren Modellen und älteren Ständen.
Abgrenzung zum Gedächtnis: Das Fenster ist kein Speicher. Was darin stand, ist nach dem Gespräch weg, solange die Oberfläche es nicht eigens ablegt.
Was das Fenster füllt
Jede Nachricht bleibt darin liegen. Bei jeder neuen Frage schickt die Oberfläche das gesamte bisherige Gespräch erneut mit, weil das Modell sich an nichts erinnert. Ein langes Gespräch wird deshalb mit jedem Schritt teurer und langsamer, obwohl die Frage am Ende kurz ist.
Anthropic beschreibt das Fenster im Glossar der Entwicklerdokumentation als Arbeitsgedächtnis des Modells: Was außerhalb liegt, ist für die aktuelle Antwort nicht vorhanden. Die Modellübersicht nennt für die gesamte aktuelle Reihe eine Million Token Fenster bei 128.000 Token Ausgabe.
Was beim Überlaufen passiert
Das hängt vom Zugang ab. Über die Schnittstelle bricht die Anfrage mit einer Fehlermeldung ab. In einer Chat-Oberfläche greift meist die Kontextkompaktierung: Das Werkzeug fasst den bisherigen Verlauf zu einer Zusammenfassung zusammen und arbeitet mit dieser weiter. Der Faden bleibt, Einzelheiten gehen verloren. Ältere Oberflächen kürzen stattdessen den Anfang des Verlaufs weg, ohne das anzuzeigen.
Auch unterhalb der Grenze gibt die Qualität nach, ein Effekt, der als Context Rot beschrieben wird. Je voller das Fenster, desto eher verliert das Modell Angaben aus der Mitte. Wer eine lange Datei anhängt und sich dann auf eine Fußnote darin beruft, bekommt häufig eine Antwort, die nur so klingt, als stünde sie dort.
Wie trotzdem nichts verloren geht
Indem das Wichtige gar nicht erst nur im Fenster steht. Das ist das Prinzip hinter allem, was gegen die Grenze hilft: Was eine Zusammenfassung überleben muss, wird außerhalb abgelegt, und im Fenster steht nur der Verweis darauf. Ein Verweis kostet eine Zeile, der Inhalt kostet Tausende Token.
Drei Formen davon sind im Einsatz. Ein Agentengedächtnis hält außerhalb des Gesprächs die Festlegungen, die über Wochen gelten, und wird zu Beginn jeder Sitzung wieder eingelesen. Feste Routinen wandern in Skripte und in abrufbare Agenten-Fähigkeiten, die sogenannten Skills, die erst geladen werden, wenn sie gebraucht werden, statt dauerhaft Platz zu belegen. Und alles, woran später jemand anknüpfen soll, wird als Datei im Projekt abgelegt, von der Arbeitsroutine über die geprüften Quellen bis zu den Regeln, auf die man sich geeinigt hat.