



Context Rot bezeichnet den Befund, dass ein Sprachmodell mit wachsender Länge der Eingabe ungenauer antwortet, lange bevor das Kontextfenster voll ist. Die Angabe steht im Fenster, und das Modell findet sie trotzdem seltener.
- Context Rot
Der Genauigkeitsverlust eines Modells, je länger die Eingabe wird.
Beispiel: „Dieselbe Frage trifft im kurzen Dokument, im hundertseitigen Anhang geht sie unter: ein Fall von Context Rot.“Auch: Kontextverfall. Beide Ausdrücke meinen dasselbe, der englische ist verbreiteter.
Abgrenzung zum Überlaufen: Das Überlaufen ist eine harte Grenze, die eine Fehlermeldung oder eine Kontextkompaktierung auslöst. Context Rot wirkt vorher und ohne Hinweis.
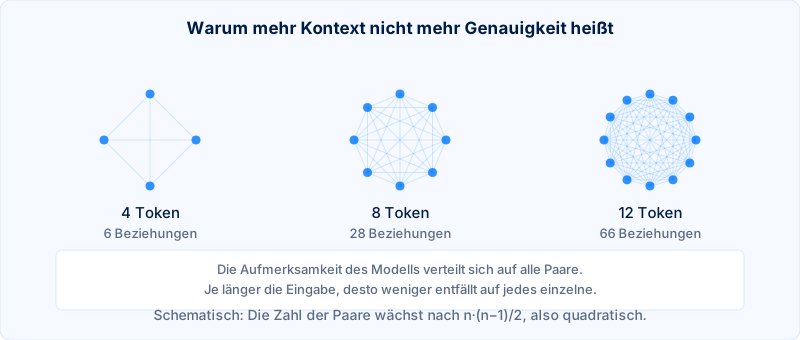
Woher der Effekt kommt
Aus der Bauweise. In der Transformer-Architektur kann jedes Token auf jedes andere achten. Bei doppelter Länge vervierfacht sich die Zahl der Paare, und die Aufmerksamkeit des Modells verteilt sich entsprechend dünner. Dazu kommt, dass Trainingsdaten überwiegend aus kürzeren Texten bestehen, mit sehr langen Eingaben also weniger Übung vorliegt.
Was gemessen wurde
Mehr als ein Eindruck aus der Praxis.
Die Untersuchung, die dem Begriff zu seiner Verbreitung verhalf, stammt von Chroma: Context Rot, 14. Juli 2025. Geprüft wurden 18 Modelle. Ergebnis im Wortlaut: Die Modelle nutzen ihren Kontext nicht gleichmäßig, ihre Leistung werde mit wachsender Eingabelänge zunehmend unzuverlässig. Der Abfall zeigte sich in allen Versuchen und fiel stärker aus, je weniger die gesuchte Stelle der Frage ähnelte.
Was im Alltag daraus folgt
Große Fenster zu meiden wäre die falsche Lehre. Die richtige: sie bewusst füllen. Den Abschnitt anhängen statt des Handbuchs, die Frage nah an das Material stellen, lange Unterhaltungen verdichten lassen und eine Suche vorschalten, wenn der Bestand groß ist. Genau dafür gibt es RAG und das Context Engineering.
In unseren Projekten fällt der Effekt am ehesten bei langen Unterhaltungen auf, in denen früh etwas vereinbart wurde. Das Modell widerspricht der Absprache nicht, es übergeht sie. Wer eine wichtige Vorgabe am Ende der Anfrage wiederholt, bekommt sie verlässlicher berücksichtigt als jemand, der sich auf den Anfang des Verlaufs verlässt.