



Inferenz ist der Vorgang, bei dem ein fertig trainiertes KI-Modell eine einzelne Anfrage beantwortet. Das Wort kommt aus der Logik und meint das Schließen von Bekanntem auf Unbekanntes. Beim Sprachmodell heißt das: aus dem Prompt Token für Token eine Antwort ableiten.
- Inferenz
Der Vorgang, bei dem ein fertig trainiertes KI-Modell eine einzelne Anfrage beantwortet.
Beispiel: „Die Inferenz dauerte vier Sekunden, das Training des Modells hatte Monate gedauert.“Auch: Inference. Der englische Ausdruck steht in jeder Abrechnung und in jeder technischen Beschreibung, der deutsche fast nur in Fachtexten.
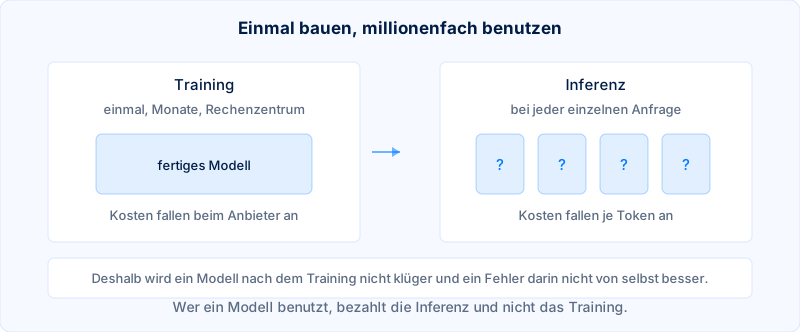
Abgrenzung zum Training: Beim Training ändern sich die Gewichte des Modells, bei der Inferenz bleiben sie unberührt. Deshalb lernt ein Modell im Gespräch nichts dazu, auch wenn es diesen Eindruck macht.
Was dabei im Modell geschieht
Eine Rechnung, und zwar jedes Mal dieselbe. Die Eingabe wird in Token zerlegt, läuft durch alle Schichten des Netzes, und am Ende steht eine Wahrscheinlichkeitsverteilung für das nächste Token. Daraus wird eines gewählt, angehängt, und der ganze Durchlauf beginnt von vorn. So entsteht eine Antwort Wort für Wort.
Warum die Antwort tröpfelt
Weil genau dieser Durchlauf je Token einmal stattfindet. Deshalb erscheint Text in Chat-Oberflächen fließend und nicht auf einen Schlag, und deshalb dauert eine lange Antwort länger als eine kurze. Die Zeit bis zum ersten Zeichen hängt dagegen an der Länge der Eingabe, die erst einmal verarbeitet werden muss.
Dass Eingabe und Ausgabe getrennt zählen, zeigt jede Preisliste. Die Modellübersicht von Anthropic weist je Modell einen Preis je Million Eingabetoken und einen höheren je Million Ausgabetoken aus. Ausgabe ist teurer, weil sie den Durchlauf je Token erzwingt.
Was daraus für die Praxis folgt
Zwei Hebel. Kürzere Antworten sind spürbar billiger und schneller, und eine Anweisung zur Länge wirkt sofort. Und wo dieselbe Eingabe mehrfach gebraucht wird, lohnt das Speichern des Ergebnisses: Dieselbe Frage zweimal zu stellen kostet zweimal.
Dazu kommt eine Eigenheit, die beim Bauen leicht übersehen wird: Die Inferenz ist zustandslos. Jede Anfrage beginnt bei null, und alles, was das Modell wissen soll, muss mitgeschickt werden. Der Eindruck eines fortlaufenden Gesprächs entsteht erst dadurch, dass die Oberfläche den bisherigen Verlauf jedes Mal erneut anhängt.