



Ein Diffusion Model erzeugt Bilder, indem es mit zufälligem Rauschen anfängt und dieses Schritt für Schritt entfernt, bis ein Bild übrig bleibt. Auf Deutsch heißt das Diffusionsmodell. Fast alle verbreiteten Bildgeneratoren arbeiten nach diesem Prinzip, und auch Ton und Video entstehen zunehmend so.
- Diffusion Model
Ein Modell, das Bilder erzeugt, indem es aus zufälligem Rauschen schrittweise die Störung entfernt.
Beispiel: „Das Diffusion Model brauchte dreißig Schritte, bis aus dem Rauschen das Produktfoto geworden war.“Woher die Richtung kommt: Der Prompt steuert jeden einzelnen Entrauschungsschritt. Deshalb wirken Änderungen am Prompt bei Bildern oft sprunghafter als bei Text, und deshalb liefert derselbe Prompt mit demselben Startrauschen dasselbe Bild.
Abgrenzung zum Sprachmodell: Ein Sprachmodell setzt Token nacheinander aneinander. Ein Diffusion Model arbeitet am ganzen Bild gleichzeitig und wiederholt das viele Male.
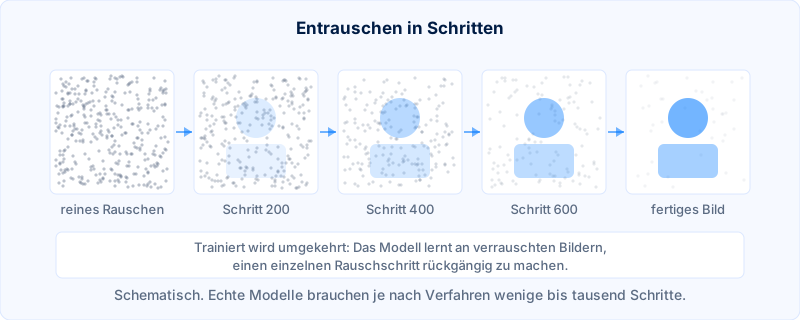
Wie aus Rauschen ein Bild wird
In vielen kleinen Schritten. Das Modell bekommt eine Fläche voller Zufallswerte und als Prompt die Anweisung, was zu sehen sein soll. Dann entfernt es in jedem Durchgang einen kleinen Teil der Störung, prüft am Prompt, ob die Richtung stimmt, und wiederholt das. Je nach Verfahren sind das wenige Dutzend bis einige hundert Durchgänge.
Wie das Training dazu passt
Es läuft genau andersherum. Dem Modell werden Bilder gezeigt, denen schrittweise Rauschen zugesetzt wurde, und es lernt, einen einzelnen dieser Schritte rückgängig zu machen. Wer das oft genug hintereinander kann, kommt auch von reinem Rauschen bis zu einem Bild.
Brauchbar für die Bilderzeugung wurde das Verfahren mit der Arbeit Denoising Diffusion Probabilistic Models von Jonathan Ho, Ajay Jain und Pieter Abbeel vom Juni 2020, die diese Modelle als eine Klasse von Modellen beschreibt, die von Überlegungen aus der Thermodynamik fernab des Gleichgewichts angeregt ist.
Was im Alltag daraus folgt
Drei Dinge. Die Zahl der Schritte ist eine Stellschraube zwischen Tempo und Güte. Das Startrauschen lässt sich festhalten, womit eine Bildidee reproduzierbar wird. Und weil jeder Lauf neu entrauscht, sind zwei Bilder aus demselben Prompt nie exakt gleich, solange das Startrauschen wechselt.
Dazu kommt die Kennzeichnung. Jedes Bild auf dieser Website, das aus einem solchen Modell stammt, trägt ein sichtbares Kennzeichen und einen entsprechenden Alternativtext.