Taalas: Wenn das KI-Modell selbst zum Chip wird
von Paul Albrecht am 31.10.2026
In Kürze: Taalas aus Toronto ätzt ein einzelnes KI-Modell fest in Silizium, statt es als Software auf einer GPU laufen zu lassen. Der Demonstrationschip HC1 trägt Llama 3.1 8B auf 815 Quadratmillimetern mit 53 Milliarden Transistoren. AMD hat das Unternehmen im August 2026 übernommen. Für Websites zählt daran vor allem eins: der Preis je Antwort.
Es gibt eine Zahl, über die in Projekten mit KI-Funktionen am Ende fast immer gestritten wird, und es ist selten die Qualität der Antworten. Es sind die Kosten je Anfrage. Eine Suche, die jede Eingabe durch ein Sprachmodell schickt, ein Assistent im Kundenkonto, eine automatische Zusammenfassung: Technisch läuft das alles längst. Ob es in den Betrieb geht, entscheidet sich daran, was tausend Anfragen am Tag kosten.
Genau an dieser Stelle setzt Taalas an, und zwar mit einer Antwort, die zunächst nach einem Scherz klingt. Das Unternehmen baut keine schnelleren Beschleuniger. Es baut Chips, in denen ein bestimmtes KI-Modell fest verdrahtet steckt.
Inhaltsverzeichnis:
Was Taalas anders macht
Was der HC1 zeigt, und was er nicht zeigt
Warum „Intelligenz als Material“ mehr ist als ein Bild
Der Preis der Festlegung
Was das für Websites bedeutet
Fazit
Was Taalas anders macht
Ein KI-Modell besteht aus Gewichten, und diese Gewichte liegen normalerweise im Speicher. Für jede einzelne Antwort holt der Chip sie von dort, rechnet damit und legt Zwischenergebnisse zurück. Dieser Weg zwischen Speicher und Rechenwerk kostet den größten Teil der Zeit und des Stroms, nicht das Rechnen selbst.
Taalas legt beides auf denselben Chip. Die Gewichte stecken als Schaltung im Silizium, das Rechenwerk sitzt daneben, und der Weg dazwischen entfällt. Das Unternehmen nennt das Ergebnis Hardcore Model, den Weg dorthin Taalas Foundry. Auf der eigenen Seite steht der Gedanke in einem Satz: das Modell ist der Computer.
Dahinter steht ein Lebenslauf. Gegründet wurde Taalas 2023 in Toronto von Ljubisa Bajic, der zuvor Tenstorrent mitgegründet und bis 2023 geführt hat. Beide Unternehmen zielen auf dieselbe Engstelle und beantworten verschieden, wie viel Beweglichkeit man dafür aufgibt. Tenstorrent baut Beschleuniger für beliebige Modelle. Taalas baut einen Chip für genau eines.
Im August 2026 hat AMD die Übernahme bekanntgegeben. In der Mitteilung von AMD steht, die Technik solle in die eigene Beschleuniger-Reihe einfließen. Die Bedingungen wurden nicht genannt.
Was der HC1 zeigt, und was er nicht zeigt
Der HC1 ist ein Demonstrationschip und kein Produkt für den Markt. Er trägt Llama 3.1 8B, ein offenes Sprachmodell mittlerer Größe, und die Eckdaten auf der Produktseite sind ungewöhnlich genug, um sie einzeln zu lesen.
Angabe | Wert |
|---|---|
Modell | Llama 3.1 8B |
Fertigung | TSMC, 6 Nanometer |
Chipfläche | 815 mm² |
Transistoren | 53 Milliarden |
Server | 2,5 kW |
Durchsatz | 17.000 Token je Sekunde und Nutzer |
815 Quadratmillimeter sind nahe an dem, was sich überhaupt belichten lässt. Es ist ein sehr großer Chip für ein vergleichsweise kleines Modell, und das ist der Kern der Wette: Die Fläche geht für die Gewichte drauf, die sonst im Speicher lägen.
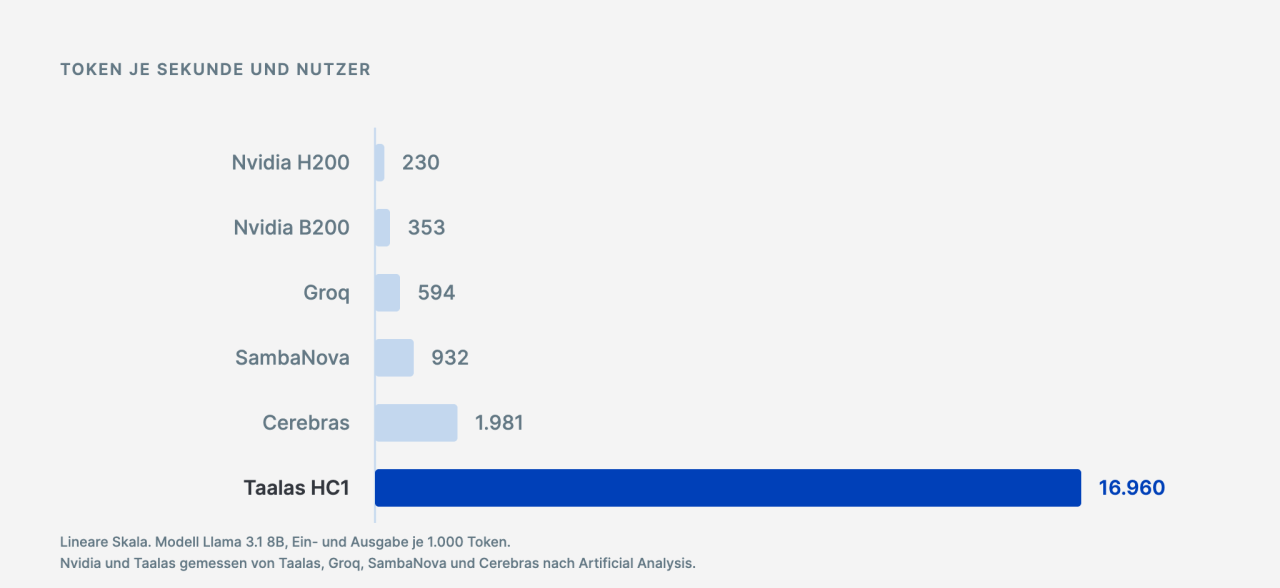
Auf einer linearen Skala schrumpfen die Balken der Wettbewerber zu Strichen. Genau das ist die Aussage, die Taalas mit der Grafik transportiert.
Beim Durchsatz lohnt der Blick auf die Fußnote. Taalas vergleicht sich dort mit NVIDIA H200 und B200, Groq, SambaNova und Cerebras. Die Werte der Wettbewerber stammen von Artificial Analysis, die eigenen aus den Laboren von Taalas, gemessen mit einer Ein- und Ausgabelänge von jeweils tausend Token. Das ist sauber gekennzeichnet und bleibt trotzdem eine Herstellerangabe. Jon Peddie Research hat den offenen Punkt benannt: ob der Vorsprung aus der Vorführung auch unter echter Last trägt.
Ausprobieren lässt es sich trotzdem. Unter chatjimmy.ai steht ein Chat, der zu jeder Antwort die Erzeugungszeit mit anzeigt. Der sichtbare Unterschied ist, dass die Antwort dasteht, sobald die Frage abgeschickt ist. Von Latenz ist praktisch nichts zu bemerken.
Warum „Intelligenz als Material“ mehr ist als ein Bild
Der Gedanke hinter dem Ansatz ist älter als Taalas. Vinay Bhaskarla hat ihn in einem Essay auf Medium zugespitzt: Intelligenz werde gerade von etwas, das man ausführt, zu etwas, das man verbaut. Seine Parallele ist die Mathematik, die im 20. Jahrhundert zur Elektronik wurde, als Logik in Silizium wanderte.
Das ist mehr als eine hübsche Figur, weil die Geschichte den Verlauf kennt. Immer wenn Rechenleistung von teuer auf billig fiel, kam der Sprung nicht aus den Anwendungen, die es schon gab. Er kam aus denen, die vorher niemand gebaut hat, weil sie sich nicht gerechnet hätten.
Genau da stehen KI-Funktionen im Web heute. Es fehlt selten das Können. Es fehlt die Rechnung.
Der Preis der Festlegung
Ein Chip trägt ein Modell. Das ist die ganze Einschränkung, und sie ist erheblich.
Modellwechsel bedeutet Fertigung. Ein nennenswert geändertes Modell braucht neues Silizium. Taalas gibt an, diesen Weg in wenigen Monaten zu gehen; gemessen an üblichen Entwicklungszeiten für Chips wäre das kurz.
Feinabstimmung bleibt möglich. Laut Herstellerangabe lassen sich Hardcore Models nachtrainieren, ohne den Chip neu zu fertigen. Wie weit das reicht, sagt die Seite nicht.
Die Gewichte stecken verkürzt im Chip. Die erste Generation arbeitet mit sehr grober Quantisierung, was das Unternehmen selbst als leichten Qualitätsverlust beschreibt.
Daraus ergibt sich, für wen der Ansatz gedacht ist: für Anwendungen, die über Jahre dasselbe Modell fahren und dabei sehr viele Anfragen beantworten. Für alles, was alle paar Monate das Modell wechselt, bleibt die GPU richtig.
Was das für Websites bedeutet
Kurzfristig nichts. Es gibt keinen Taalas-Chip zu kaufen, und bis so etwas in einem Hostingangebot auftaucht, vergehen Jahre. Mittelfristig ändert sich die Größe, an der KI-Funktionen im Web heute scheitern.
Aus unserer Arbeit an über 2.500 Website-Projekten kennen wir die Stelle gut: Eine KI-Funktion wird selten verworfen, weil sie nicht funktioniert. Sie wird verworfen, weil sie bei realistischer Nutzung zu teuer wird oder zu lange braucht. Eine Produktsuche, die jede Eingabe durch ein Modell schickt, ist in der Vorführung großartig und im Betrieb eine monatliche Rechnung.
Sinkt der Preis je Antwort um Größenordnungen, verschiebt sich diese Grenze. Dann rechnen sich Funktionen, die heute in jeder zweiten Budgetrunde gestrichen werden. Und es verschiebt sich eine zweite Größe, über die seltener gesprochen wird: der Strom. Ein Ansatz, der ohne Hochgeschwindigkeitsspeicher und ohne Flüssigkühlung auskommt, verändert die Betriebskosten an einer Stelle, an der sie derzeit am schnellsten wachsen.
Für die Praxis heißt das vorerst: Rechne weiter mit den Preisen von heute. Aber plane Architekturen so, dass das Modell austauschbar bleibt. Wer seine KI-Funktion an einen einzigen Anbieter nagelt, kann einen Preissturz nicht mitnehmen.
Fazit
Taalas ist eine Wette darauf, dass KI-Modelle lange genug stabil bleiben, um sie in Hardware zu gießen. Ob diese Wette aufgeht, entscheidet sich daran, ob die Zahlen aus der Vorführung auch unter echter Last und über eine Modellgeneration hinweg tragen. Die Übernahme durch AMD ist das erste starke Signal, dass jemand mit Erfahrung in diesem Markt daran glaubt.
Für alle, die Websites bauen, ist die Nachricht unspektakulärer und trotzdem brauchbar. Die interessante Frage bei KI im Web ist seit einiger Zeit nicht mehr, was ein Modell kann. Sie lautet, was eine Antwort kostet. Jeder ernsthafte Versuch, diese Zahl um Größenordnungen zu drücken, ist deshalb einen Blick wert, auch wenn er aus einer Richtung kommt, die mit Webentwicklung erst einmal nichts zu tun hat.