



DevOps ist eine Arbeitsweise, die Entwicklung und Betrieb von Software zusammenbringt. Entwickler und Betrieb tragen dabei gemeinsam die Verantwortung dafür, dass Änderungen schnell und sicher live gehen.
- DevOps
Eine Kultur und Praxis, die Entwicklung und IT-Betrieb verbindet und Test, Auslieferung und Überwachung weitgehend automatisiert.
Beispiel: „Nach der Umstellung auf DevOps geht eine Korrektur am selben Tag live statt im nächsten Wartungsfenster.“Der Name verbindet Development und Operations. Bekannt wurde er 2009 mit den ersten DevOpsDays im belgischen Gent, die Patrick Debois organisiert hat.
Was zu DevOps gehört
Automatisierung über die ganze Kette: Jede Änderung wird per Continuous Integration geprüft, automatisch ausgeliefert und im Betrieb überwacht. Server und Umgebungen werden als Code beschrieben statt von Hand eingerichtet, sodass sie sich jederzeit gleich neu aufbauen lassen.
Dazu kommen kurze Rückmeldungen. Fehler im Betrieb landen direkt beim Team, das die Änderung gebaut hat, und Auswertungen zeigen, was nach einer Änderung besser oder schlechter läuft.
Typische Werkzeuge bei DevOps
Git als Grundlage, Pipelines in GitHub Actions oder GitLab CI, Container mit Docker, Infrastruktur als Code mit Terraform und Überwachung mit Diensten für Logs, Messwerte und Fehler.
DevOps bei Websites
Auch kleine Projekte profitieren davon. Diese Website wird bei jedem Push auf den Hauptzweig über Laravel Forge ohne Ausfallzeit neu ausgeliefert: Der Server baut eine neue Fassung im Hintergrund auf und schaltet erst um, wenn alles steht.
Schlägt das Deployment fehl, läuft die alte Fassung einfach weiter, und niemand muss nachts eingreifen.
Wie DevOps entstanden ist
Aus einem Konflikt zwischen zwei Abteilungen. Die Entwicklung wollte Neues ausliefern, der Betrieb wollte Ruhe auf den Servern. Im Juni 2009 zeigten John Allspaw und Paul Hammond auf der Konferenz Velocity in ihrem Vortrag 10+ Deploys per Day, wie Flickr den Streit beilegte: mit automatisierter Infrastruktur, gemeinsamer Versionsverwaltung, Bauen und Ausrollen in einem Schritt, Feature Flags und gemeinsamen Messwerten, dazu mit einer Kultur ohne Schuldzuweisung.
Patrick Debois hatte das Thema schon 2008 auf der Konferenz Agile in Toronto unter dem Titel Agile Infrastructure vorgetragen. Für seine eigene Konferenz am 30. und 31. Oktober 2009 in Gent war Agile System Administration Days als Name für Twitter zu lang; daraus wurde DevOpsDays und daraus DevOps (Debois 2021). Auf der Konferenzseite stand das Wort schon im August 2009. Eine offizielle Definition oder ein Manifest hat Debois bewusst nicht geschrieben.
Die DevOps-Schleife: acht Phasen
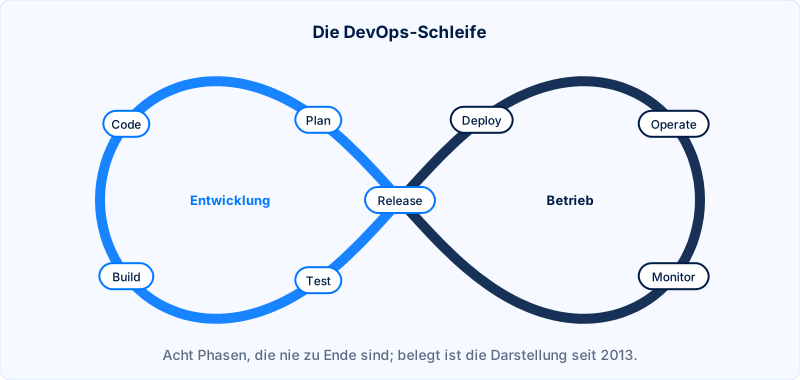
Die bekannteste Darstellung von DevOps ist eine liegende Acht. Auf der Seite der Entwicklung stehen Plan, Code, Build und Test, in der Mitte das Release, auf der Seite des Betriebs Deploy, Operate und Monitor. Belegt ist sie spätestens 2013 in einem Blogbeitrag von Dustin Whittle bei AppDynamics; wer sie zuerst gezeichnet hat, ist nicht bekannt. Die Schleife zeigt den Weg einer einzelnen Änderung. In der Praxis laufen die Phasen gleichzeitig, weil viele Änderungen zugleich unterwegs sind.
Phase | Typische Werkzeuge |
|---|---|
Plan | Issues und Boards in GitHub oder GitLab, Jira |
Code | Git, gehostet bei GitHub, GitLab oder Bitbucket |
Build | Composer, npm und Vite, Container mit Docker |
Test | PHPUnit, Pest, Playwright für Tests im Browser |
Release | |
Deploy | Laravel Forge, Kubernetes, Argo CD |
Operate | Infrastructure as Code mit Terraform, Konfiguration mit Ansible |
Monitor | Prometheus, Grafana, Sentry, Erreichbarkeitsprüfungen |
Daraus folgt: Viele Plattformen decken mehrere Phasen ab, GitHub und GitLab reichen von der Planung bis zur Auslieferung. Die Zuordnung ist eine Gewohnheit der Branche und keine Norm.
CALMS und die Three Ways: zwei Modelle für DevOps
CALMS fasst DevOps in fünf Buchstaben: Culture, Automation, Lean, Measurement, Sharing. Die erste Fassung ohne L stellte John Willis im Juli 2010 als CAMS vor, mit der Kultur an erster Stelle; das L für Lean soll später Jez Humble ergänzt haben (InfoQ).
Gene Kim beschrieb 2012 die Three Ways: den Fluss durch die ganze Wertkette, schnelle Rückmeldung vom Betrieb an die Entwicklung und eine Kultur des Experimentierens und Lernens. Bekannt wurden sie durch seinen Roman The Phoenix Project von 2013 und durch das DevOps Handbook von 2016, das Kim mit Humble, Debois und Willis schrieb.
Wie man DevOps misst: die DORA-Kennzahlen
Mit fünf Kennzahlen aus dem Forschungsprogramm DORA. Drei messen den Durchsatz: die Zeit vom Commit bis zur Produktion, die Häufigkeit der Auslieferungen und die Zeit, sich von einer fehlgeschlagenen Auslieferung zu erholen. Zwei messen die Instabilität: den Anteil der Auslieferungen, die sofort korrigiert werden müssen, und seit 2024 den Anteil ungeplanter Auslieferungen nach einem Vorfall. Der Bericht 2024 teilte die knapp 3.000 Befragten in vier Gruppen ein.
Gruppe | Commit bis Produktion | Auslieferungen | Fehlerquote | Erholung | Anteil |
|---|---|---|---|---|---|
Elite | unter einem Tag | bei Bedarf, mehrmals täglich | 5 % | unter einer Stunde | 19 % |
High | ein Tag bis eine Woche | täglich bis wöchentlich | 20 % | unter einem Tag | 22 % |
Medium | eine Woche bis ein Monat | wöchentlich bis monatlich | 10 % | unter einem Tag | 35 % |
Low | ein bis sechs Monate | monatlich bis halbjährlich | 40 % | eine Woche bis ein Monat | 25 % |
Daraus folgt: Tempo und Stabilität schließen sich nicht aus. Die Elite liefert 182-mal häufiger aus als die Gruppe Low und hat dabei eine achtmal niedrigere Fehlerquote. Auffällig ist die Mitte: Die Gruppe Medium arbeitet langsamer als High, scheitert aber nur halb so oft. Der Bericht 2025 kennt keine solchen Stufen mehr und sortiert die Teams stattdessen in sieben Typen.
DevOps, SRE und Platform Engineering
Site Reliability Engineering, kurz SRE, ist bei Google aus dem Betrieb entstanden. Laut SRE-Buch entsteht es, wenn man Softwareentwickler ein Betriebsteam entwerfen lässt; höchstens die Hälfte ihrer Zeit verbringen sie dort mit Betriebsarbeit. Das SRE Workbook von 2018 beschreibt das Verhältnis mit einer Zeile Programmcode: class SRE implements interface DevOps. DevOps ist also die allgemeine Haltung, SRE eine bestimmte Umsetzung mit festen Regeln wie dem Fehlerbudget.
Platform Engineering setzt eine Ebene tiefer an. Nach dem Platforms White Paper der CNCF von 2023 baut ein eigenes Team eine Plattform mit Vorlagen und Selbstbedienung, die Produktteams wie ein Produkt nutzen. Unter dem Namen DevSecOps rückt außerdem die Sicherheit in die Pipeline: Das NIST beschreibt 2022, wie Prüfungen automatisch in Build, Test und Auslieferung laufen.
Was DevOps nicht ist
Ein eigenes Team zwischen Entwicklung und Betrieb ist nach Matthew Skeltons Sammlung DevOps Topologies ein bekanntes Muster, das scheitert, weil es zu einem weiteren Silo wird. Jez Humble schrieb schon 2012, ein DevOps-Team gebe es nicht, und verwies auf Werner Vogels von Amazon: Wer etwas baut, betreibt es auch. Als Ausnahme gilt ein Team, das eine Plattform für alle anderen baut, oder eines, das sich befristet überflüssig machen soll.
Auch Werkzeuge allein ergeben kein DevOps. Rouan Wilsenach schreibt auf martinfowler.com, ohne passende Kultur bleibe DevOps ein Schlagwort. Wer nur die Stellenbezeichnung der Administratoren in DevOps Engineer ändert, hat nach Skelton ebenfalls nichts gewonnen.
Die DORA-Kennzahlen für die eigene Website messen
Pro Anwendung messen und den Verlauf über die Zeit beobachten. DORA rät in seinem Leitfaden davon ab, Teams miteinander zu vergleichen oder die Kennzahlen zur Zielvorgabe zu machen, und empfiehlt, mit einem Gespräch zu beginnen statt mit teurer Messtechnik. Für eine Website auf Laravel Forge liefert die Liste der Deployments schon die Häufigkeit. Zur Einordnung: Im Bericht 2025 lieferten 16,2 Prozent der Befragten bei Bedarf mehrmals täglich aus, und nur 9,4 Prozent brauchten vom Commit bis zur Produktion weniger als eine Stunde.
Mit DevOps in einem kleinen Team anfangen
Mit Versionsverwaltung, automatischem Ausrollen und einer Überwachung. Für Flickr war 2009 die automatisierte Infrastruktur der Schritt, den man als Erstes gehen sollte. DORA zählt Versionsverwaltung, automatisiertes Deployment, Continuous Integration, Monitoring und kleine Arbeitspakete zu den Fähigkeiten, die messbar helfen. Danach den größten Engpass gemeinsam angehen und nach einem Monat erneut messen.
Eine fehlerhafte Änderung schnell zurücknehmen
Mit atomaren Releases, bei denen die alte Fassung liegen bleibt. Laravel Forge legt jede neue Fassung in ein eigenes Verzeichnis und schaltet erst am Ende einen Verweis um; standardmäßig bleiben die letzten vier Deployments für einen Rollback erhalten (Forge-Doku). Bei dieser Website bleibt die vorige Fassung als Ziel für den Rückweg vorgewärmt. Wie schnell das gehen sollte, zeigt der DORA-Bericht 2024: Die Elite erholt sich von einer fehlgeschlagenen Auslieferung in weniger als einer Stunde.
Silos auflösen, ohne ein DevOps-Team zu gründen
Wer eine Änderung baut, betreibt sie mit, und ein Plattformteam liefert Selbstbedienung statt Tickets. So beschreiben es Humble und das White Paper der CNCF: Die Produktteams tragen die Folgen ihrer Änderungen selbst, das Plattformteam nimmt ihnen die wiederkehrende Arbeit ab. Für eine Agentur heißt das, dass Entwickler ihre Projekte auch im Betrieb sehen, mit Zugriff auf Protokolle, Fehlerberichte und Messwerte.