
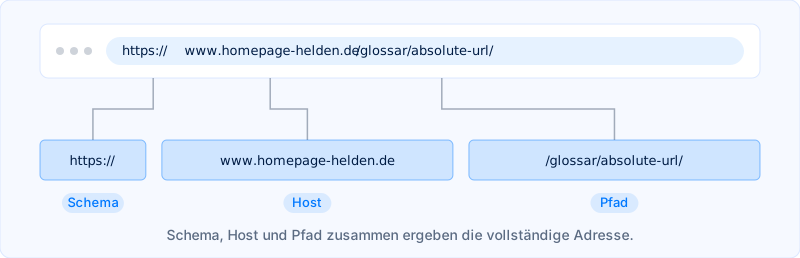
Eine absolute URL ist eine vollständige Webadresse aus Schema, Host und Pfad, zum Beispiel https://www.homepage-helden.de/journal/. Sie bezeichnet eine Ressource eindeutig und funktioniert unabhängig davon, in welchem Dokument der Link steht. Eine relative URL wie /journal/ ergänzt der Browser erst um Schema und Domain der Seite, auf der er sie gefunden hat.
- Absolute URL
Webadresse, die alle Angaben enthält, die zum Auffinden einer Ressource nötig sind: Schema, Host und Pfad.
Beispiel: „Für den Canonical-Tag brauchst du eine absolute URL, ein Pfad allein reicht dort nicht.“Umgangssprachlich wird der Begriff auch für Pfade ab dem Wurzelverzeichnis benutzt, etwa /glossar/absolute-url/. Technisch ist das eine relative URL mit absolutem Pfad, weil Schema und Domain fehlen.
Gegenbegriff: Die relative URL nennt nur den Teil der Adresse, der sich vom aktuellen Dokument aus ergibt, und wird vom Browser vervollständigt.
Woraus eine absolute URL besteht
Jede absolute URL setzt sich aus denselben Bausteinen zusammen. Die Adresse dieser Seite zeigt sie der Reihe nach, hier um die beiden optionalen Teile am Ende ergänzt: https://www.homepage-helden.de/glossar/absolute-url/?utm_source=newsletter#aufbau
Bestandteil | In dieser URL | Wozu er da ist |
|---|---|---|
Schema | https:// | Legt fest, über welches Protokoll der Browser die Seite anfordert. Bei Websites ist das heute durchgehend HTTPS. |
Host | www.homepage-helden.de | Benennt den Server: Subdomain www, Domain homepage-helden und Top-Level-Domain de. |
Pfad | /glossar/absolute-url/ | Zeigt auf die einzelne Seite innerhalb dieser Domain. |
Query-String | ?utm_source=newsletter | Optional. Übergibt Parameter an den Server, etwa zur Auswertung einer Kampagne. |
Fragment | #aufbau | Optional. Sprungmarke innerhalb der Seite. Der Browser wertet sie selbst aus und sendet sie nicht an den Server. |
Pflicht sind Schema und Host. Fehlt der Pfad, meint die Adresse die Startseite. Query-String und Fragment kommen je nach Zweck dazu. Genau darin liegt der Unterschied zur relativen URL: Die absolute Adresse trägt alles mit sich, was zum Auffinden der Seite nötig ist, und braucht keinen Bezugspunkt.
Wo die vollständige Adresse Pflicht ist
Überall dort, wo eine Adresse außerhalb ihres Dokuments gelesen wird, brauchst du die vollständige Form. Das gilt für den Canonical-Tag im Head und für die Einträge in der sitemap.xml, ebenso für die Open-Graph-Angaben, die LinkedIn oder Facebook beim Teilen auslesen. Genauso für Links in Newslettern, RSS-Feeds und PDF-Dokumenten: Sie werden in einer Umgebung geöffnet, die von deiner Website nichts weiß, und ein relativer Pfad hätte dort keinen Bezugspunkt.
<!-- Im Head: beide Angaben verlangen die vollständige Adresse -->
<link rel="canonical" href="https://www.homepage-helden.de/glossar/absolute-url/">
<meta property="og:url" content="https://www.homepage-helden.de/glossar/absolute-url/">
Absolute URLs im Redaktionsalltag
Innerhalb einer Website ist die Sache offener. Für Google ist es gleichgültig, ob ein interner Link absolut oder relativ gesetzt ist, solange er sich auflösen lässt. Kritisch wird es, wenn die volle Adresse von Hand in den Editor kopiert wird: Dann steht die Domain im Content und damit in der Datenbank. Beim Umzug auf eine neue Domain oder beim Test auf einer Staging-Umgebung zeigen genau diese Links weiter auf die alte Adresse. Aus unseren Relaunch-Projekten ist das einer der häufigsten Gründe, warum nach dem Livegang interne Links ins Leere laufen oder Besucher unbemerkt wieder auf der alten Seite landen.
Wir empfehlen deshalb, interne Verlinkungen immer über die Link-Funktion des CMS zu setzen. TYPO3 speichert dabei eine Referenz der Form t3://page?uid=42, Statamic eine der Form statamic://entry::id. Beide werden erst beim Rendern der Seite in eine URL übersetzt und ziehen mit, wenn sich Domain oder Slug ändern. WordPress legt stattdessen die fertige absolute URL im Beitragstext ab, weshalb bei einem Domainwechsel ein Suchen-und-Ersetzen über die Datenbank fällig wird.
Warum Adressen normalisiert werden
Dieselbe Seite lässt sich oft über mehrere Adressen erreichen, und technisch sind das verschiedene URLs: mit und ohne www, mit und ohne Schrägstrich am Ende, über HTTP und HTTPS, mit unterschiedlicher Groß- und Kleinschreibung. Der Host ist dabei unempfindlich gegen Groß- und Kleinschreibung, der Pfad nicht. /Glossar/ und /glossar/ sind zwei Adressen, und auf einem Linux-Server führt nur eine davon zum Ziel.
Für Suchmaschinen entstehen daraus Dubletten. Zu jeder Website gehört deshalb eine Festlegung, welche Schreibweise gilt, eine Weiterleitung aller anderen darauf und ein Canonical-Tag mit genau dieser Adresse. Wer den Canonical mit Schrägstrich setzt, die Seite aber ohne ausliefert, verweist auf eine Adresse, die weiterleitet.
Sonderzeichen und Umlaute
In einer URL sind nur bestimmte Zeichen erlaubt, alles andere wird prozentkodiert: aus einem Leerzeichen wird %20, aus einem Ü im Pfad %C3%9C. Im Hostnamen gilt ein anderes Verfahren, dort steht Punycode. Eine Domain mit Umlaut wird technisch als xn---Form übertragen, und genau diese steht in Zertifikaten, Serverkonfigurationen und Auswertungen. Wer eine Umlautdomain betreibt, sollte beide Schreibweisen kennen, weil Werkzeuge mal die eine und mal die andere ausgeben.
Die protokollrelative Adresse ist überholt
Eine Zeit lang war es üblich, das Schema weggelassen und mit zwei Schrägstrichen begonnen: //example.com/logo.svg. Der Browser ergänzte dann das Schema der aktuellen Seite. Das war praktisch, solange Websites teils über HTTP und teils über HTTPS liefen. Heute ist HTTPS der Regelfall, die Schreibweise bringt keinen Vorteil mehr und führt außerhalb des Browsers zu Fehlern, etwa wenn dieselbe Adresse in einer E-Mail oder einem PDF landet. Schreibe das Schema aus.
Wo die vollständige Adresse in Daten steht
Über die sichtbaren Links hinaus taucht die absolute URL in den strukturierten Daten auf. Der Bezeichner @id eines Schema.org-Objekts ist eine absolute URL, ebenso die Angaben zu Bildern und Logos. Ein relativer Pfad wird dort nicht aufgelöst, weil die Daten außerhalb des Dokuments weiterverarbeitet werden. Dasselbe gilt für die Einträge in einem RSS-Feed und für hreflang-Angaben zwischen Sprachversionen. Auch der URL-Slug spielt hier mit: Ändert er sich, ändert sich die absolute Adresse in all diesen Daten mit, und jede davon muss nachgezogen werden.