



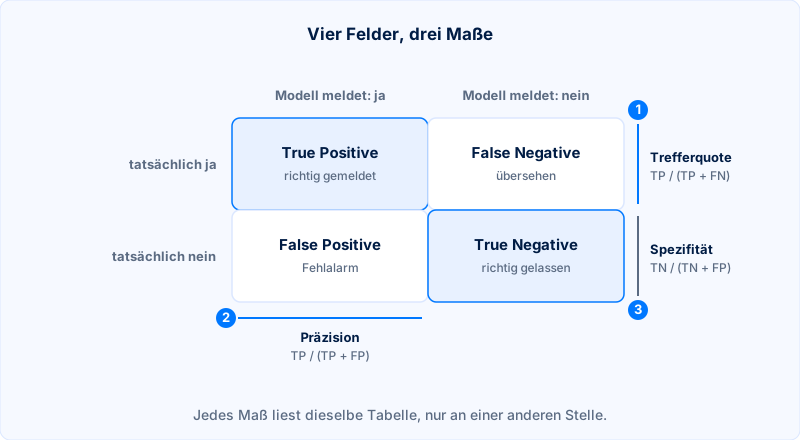
Die Trefferquote ist im Machine Learning das Maß dafür, welchen Anteil der tatsächlich vorhandenen Fälle ein Modell findet. Bei einer Trefferquote von 40 Prozent bleiben von hundert echten Fällen sechzig unentdeckt. Sie beantwortet die Frage nach der Vollständigkeit der Suche und sagt nichts darüber, wie viele der Meldungen daneben lagen.
- Trefferquote
Der Anteil der tatsächlich vorhandenen Fälle, den ein Modell findet.
Beispiel: „Die Trefferquote lag bei 40 Prozent, also blieben drei von fünf Fällen liegen.“Berechnet aus zwei Feldern der Confusion Matrix: die gefundenen Fälle geteilt durch alle vorhandenen, also TP / (TP + FN).
Auch: Sensitivität, Recall, Richtig-Positiv-Rate. Sensitivität ist der Name in Medizin und Statistik, Recall der in der englischsprachigen Fachliteratur und in den Werkzeugen.
Das Gegenstück auf der anderen Seite der Matrix ist die Spezifität: Sie misst, welcher Anteil der unauffälligen Fälle auch unauffällig blieb.
Wann die Trefferquote vorgeht
Wo ein übersehener Fall teuer ist und eine überflüssige Prüfung billig. In der Krebsvorsorge kostet ein übersehener Befund Leben, ein Fehlalarm eine zweite Untersuchung. In der Betrugserkennung kostet die durchgerutschte Buchung Geld, die geprüfte Buchung zehn Minuten. In beiden Fällen wird die Schwelle so gesetzt, dass die Trefferquote steigt, und die Nachprüfung durch Menschen fängt den Rest auf.
Warum eine hohe Trefferquote allein nichts beweist
Weil auch sie sich erkaufen lässt, nur in die andere Richtung. Ein Modell, das jeden Fall meldet, findet alle echten und erreicht hundert Prozent Trefferquote. Die Meldungen sind dann wertlos, weil jemand sie alle von Hand sortieren muss.
Die Trefferquote gehört deshalb immer zusammen mit der Präzision in den Bericht, dazu die Schwelle, bei der beide gemessen wurden.
Warum die Trefferquote drei Namen trägt
Weil drei Fächer dieselbe Größe gebraucht haben. In der Medizin heißt sie Sensitivität, weil sie beschreibt, wie empfindlich ein Test auf den gesuchten Fall anspricht. In der Statistik heißt sie Richtig-Positiv-Rate und bildet zusammen mit der Falsch-Positiv-Rate die ROC-Kurve. Im Machine Learning heißt sie Recall, wörtlich Abruf: Gemessen wird, wie viel von dem Vorhandenen das Modell zurückholt.
Für die Verständigung heißt das vor allem eines: Wer in einem Bericht Sensitivität liest und im Werkzeug Recall abliest, vergleicht dieselbe Zahl und nicht zwei.