



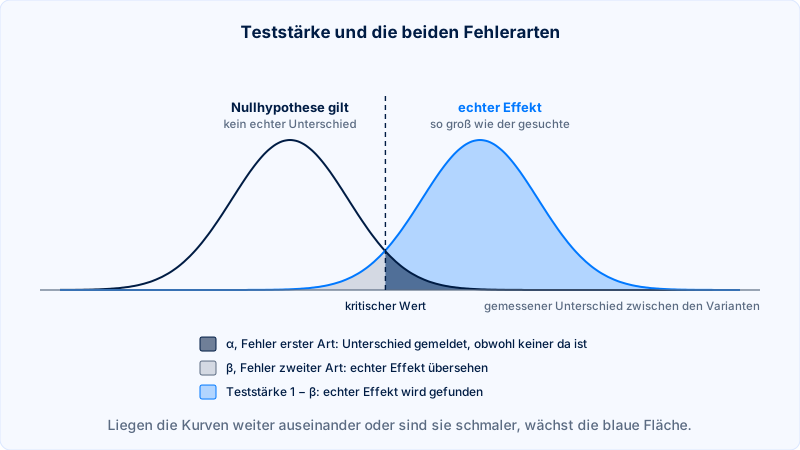
Die Teststärke ist die Wahrscheinlichkeit, mit der ein statistischer Test einen tatsächlich vorhandenen Effekt als signifikant erkennt. Das Dorsch Lexikon der Psychologie beschreibt sie als 1 − β, das Gegenstück zur Wahrscheinlichkeit eines Fehlers zweiter Art. Im Englischen heißt sie Statistical Power.
- Teststärke
Die Wahrscheinlichkeit, dass ein statistischer Test einen tatsächlich vorhandenen Effekt der geplanten Größe als signifikant erkennt, geschrieben 1 − β.
Beispiel: „Weil die Teststärke zu gering war, blieb der echte Vorteil der neuen Seite im Test unentdeckt.“Auch: Statistical Power; engl. power = Stärke, Macht.
Abgrenzung zum False Negative: Er ist der übersehene Effekt selbst, der Fehler zweiter Art; die Teststärke ist die Wahrscheinlichkeit, ihn zu vermeiden.
Was die Teststärke bestimmt
Die Teststärke ist eine Planungsgröße mit mehreren Stellschrauben. Kohavi und Kollegen nennen 2009 als üblichen Zielwert 80 bis 95 Prozent und betonen, dass sie sich nicht direkt einstellen lässt. Sie steigt mit der Größe des gesuchten Effekts und mit kleinerem Standardfehler; ein strengeres Konfidenzniveau senkt sie.
Den Standardfehler verringern laut den Autoren mehr Nutzer, also meist eine längere Laufzeit, eine Zielgröße mit weniger Streuung und das Weglassen von Besuchern, die die Änderung gar nicht gesehen haben. Wie sich daraus die nötige Stichprobengröße ergibt, steht dort; der kleinste gesuchte Unterschied ist der minimal nachweisbare Effekt.
Teststärke und die Deutung von Ergebnissen
Laut Dorsch braucht man die Teststärke für jedes Ergebnis, signifikant oder nicht. Bleibt ein Test ohne Befund, spricht das nur dann für die Nullhypothese, wenn die Teststärke schon für kleine Abweichungen hoch war. Kohavi warnt davor, eine Änderung ohne signifikanten Unterschied einzuführen, weil sie „nicht schadet“: Das Experiment kann negativ und nur zu schwach gewesen sein.
Schwache Tests verzerren auch die Treffer. Katherine Button und Kollegen zeigten 2013, dass geringe Teststärke die Wahrscheinlichkeit senkt, dass ein signifikantes Ergebnis einen echten Effekt widerspiegelt; die mittlere Teststärke neurowissenschaftlicher Studien schätzten sie auf etwa 8 bis 31 Prozent. Andrew Gelman und John Carlin zeigen 2014, dass signifikante Schätzungen bei einer Teststärke deutlich unter 50 Prozent den Effekt stark übertreiben und unter 10 Prozent oft sogar das falsche Vorzeichen haben.
Teststärke im Website-Alltag
Cohen hat laut Dorsch zwei Formen der Teststärkeanalyse vorgeschlagen: die A-priori-Analyse, die vor der Studie den nötigen Umfang berechnet, und die Post-hoc-Analyse für schon vorliegende Untersuchungen. Für Website-Tests zählt die erste; als Werkzeug nennt Dorsch Programme wie G*Power.
Aus unserer Sicht erreichen Tests auf kleinen Websites die üblichen 80 Prozent selten, weil der Verkehr fehlt. Ein knapper Sieger aus so einem Test ist deshalb mit Vorsicht zu lesen; die gemessene Verbesserung fällt im Betrieb meist kleiner aus.