



Prompt Injection ist ein Angriff, bei dem eine untergeschobene Anweisung das Verhalten eines Sprachmodells verändert. Weil ein Modell Anweisung und Material im selben Text verarbeitet, kann es den Unterschied zwischen beiden nicht zuverlässig erkennen.
- Prompt Injection
Ein Angriff, bei dem eine untergeschobene Anweisung das Verhalten eines Sprachmodells verändert.
Beispiel: „Die Prompt Injection stand im Lebenslauf und wies das Modell an, den Bewerber als bestens geeignet zu bewerten.“Zwei Spielarten: die direkte, bei der der Nutzer selbst tippt, und die indirekte, bei der die Anweisung in einem Inhalt steckt, den das Modell verarbeitet. Die zweite ist die gefährlichere.
Woher der Name kommt: aus der Verwandtschaft zur SQL-Injection, bei der eingeschleuster Code als Befehl ausgeführt wird. Der Vergleich trägt bis zu einem Punkt und bricht dann: Bei SQL lässt sich Befehl und Daten sauber trennen, bei Sprache nicht.
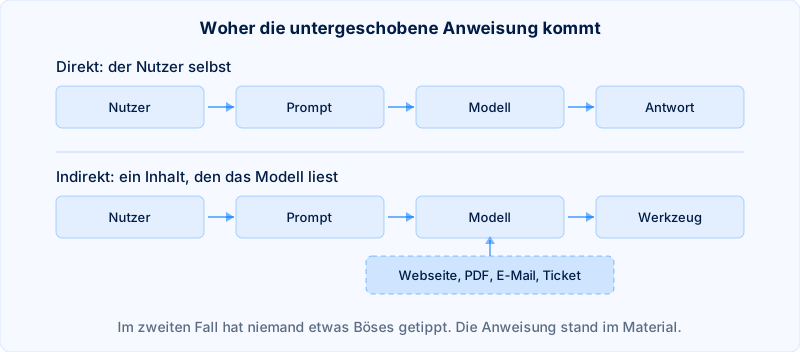
Wie der Angriff aussieht
Als harmloser Text mit einer Anweisung darin.
Die Beschreibung bei OWASP fasst die Schwachstelle so: Sie liegt vor, wenn Eingaben das Verhalten oder die Ausgabe eines Sprachmodells auf unbeabsichtigte Weise verändern. Ausdrücklich zählen auch Eingaben dazu, die ein Mensch gar nicht sehen kann, etwa weißer Text auf weißem Grund.
Warum es sich schwer verhindern lässt
Weil es keine technische Trennung zwischen Anweisung und Inhalt gibt. Ein Sprachmodell bekommt einen Strom aus Zeichen und muss daraus schließen, was Auftrag ist. Filter helfen gegen bekannte Formulierungen und versagen gegen neue; die Forschung hat bisher keine verlässliche Abwehr hervorgebracht.
Was trotzdem hilft
Die Rechte begrenzen. Ein Modell, das nur lesen darf, richtet durch eine untergeschobene Anweisung wenig an. Gefährlich wird es dort, wo ein KI-Agent schreiben, versenden oder bezahlen kann. In unseren Projekten gilt deshalb: Jeder Schritt mit Außenwirkung braucht eine Freigabe durch einen Menschen.
Dazu kommt die Trennung der Zuständigkeiten. Wenn ein Modell Material verarbeitet, das von außen kommt, sollte es dafür möglichst wenig dürfen; und was es daraus macht, geht an eine Stelle, die prüft, statt direkt in ein System, das handelt.