



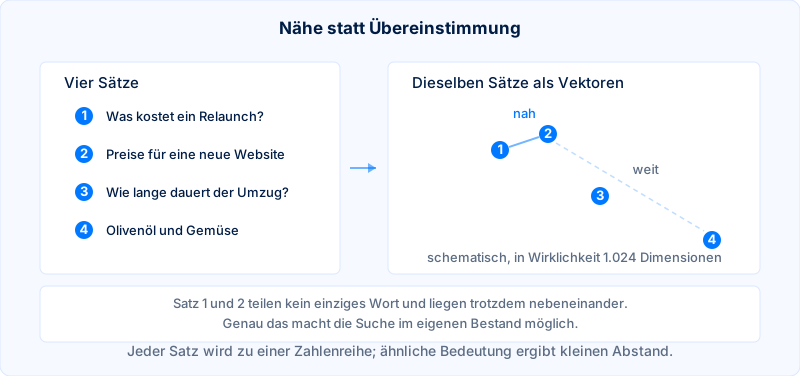
Ein Embedding ist eine Zahlenreihe, die ein eigens dafür trainiertes KI-Modell aus einem Text berechnet und deren Lage im Raum seine Bedeutung abbildet. Zwei Texte, die dasselbe meinen, liegen nah beieinander, auch wenn sie kein Wort gemeinsam haben. Darauf beruht jede Suche, die nach Sinn statt nach Zeichenfolge geht.
- Embedding
Eine von einem KI-Modell berechnete Zahlenreihe, die die Bedeutung eines Textes abbildet.
Beispiel: „Die Suche findet den Abschnitt über Preise, obwohl in der Frage ‚Was kostet das?‘ steht: Das Embedding bringt beide zusammen.“Größenordnung: Übliche Vektoren haben 1.024 Zahlen, daneben gibt es 256, 512 und 2.048. Mehr Zahlen bilden feiner ab und kosten mehr Speicher; die Ähnlichkeit wird über den Winkel oder den Abstand zwischen zwei Vektoren berechnet.
Abgrenzung zum Token: Ein Token ist ein Stück Text. Ein Embedding ist eine Aussage über Bedeutung. Die Zerlegung in Token geht der Berechnung voraus.
Wie daraus eine Suche wird
In zwei Schritten. Zuerst bekommt jeder Abschnitt des eigenen Bestands ein Embedding, das gespeichert wird. Kommt eine Frage, wird auch sie in ein Embedding übersetzt, und gesucht wird nach den Abschnitten, deren Zahlenreihen der Frage am nächsten liegen. Genau dieser Schritt steckt in jedem RAG-System.
Die Dokumentation von Anthropic beschreibt Embeddings als numerische Darstellungen von Text, mit denen sich inhaltliche Ähnlichkeit messen lässt, und nennt als Anwendungsfälle Suche, Empfehlungen und das Aufspüren von Ausreißern. Anthropic bietet dafür kein eigenes Modell an und verweist auf Anbieter, die darauf spezialisiert sind.
Was beim Einsatz zu beachten ist
Embeddings verschiedener Modelle sind nicht vergleichbar. Wer das Modell wechselt, muss den ganzen Bestand neu berechnen, und bis das durch ist, liefert die Suche gemischte Ergebnisse. Das ist der Grund, warum der Modellwechsel bei einer Suche mehr Arbeit macht als bei einem Sprachmodell.
Wo sie sonst noch helfen
Überall dort, wo Ähnlichkeit zählt: doppelte Einträge in einem Datenbestand finden, Anfragen automatisch einsortieren, verwandte Artikel vorschlagen, Ausreißer entdecken. In unseren Projekten ist der häufigste Einsatz jenseits der Suche das Aufspüren von Dubletten, etwa bei Begriffen, die zweimal unter verschiedenen Namen angelegt wurden.