



Ein Clone holt ein Repository zum ersten Mal auf den eigenen Rechner, samt seiner gesamten Geschichte. Danach hast du eine vollständige Kopie: alle Commits, alle Zweige, alle Marken. Er wird einmal am Anfang ausgeführt, danach halten Fetch und Pull den Stand aktuell.
- Clone
Das erstmalige Holen eines Repositorys samt seiner gesamten Geschichte.
Beispiel: „Ein Clone des Projekts dauert zwei Minuten, danach läuft alles lokal.“Dabei entstehen drei Dinge auf einmal: das lokale Repository, das Arbeitsverzeichnis mit den Dateien und ein Verweis auf die Herkunft, der üblicherweise
originheißt.Abgrenzung zum Fork: Ein Fork ist eine Kopie auf dem Server unter deinem Namen. Ein Clone ist eine Kopie auf deinem Rechner. Wer zu einem fremden Projekt beitragen will, macht beides nacheinander.
Was beim Clone mitkommt
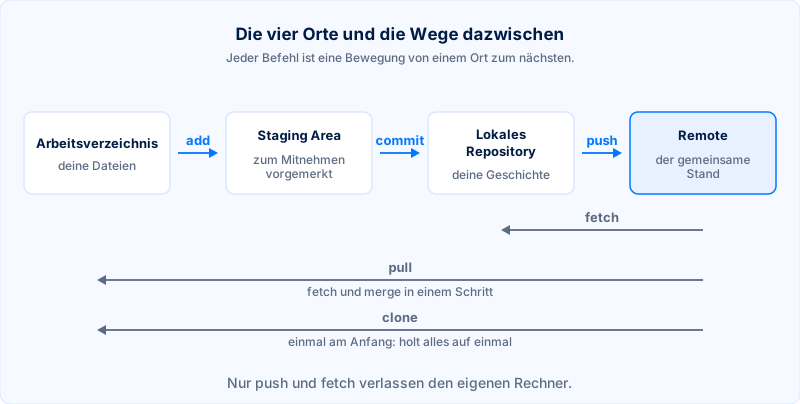
Die vollständige Geschichte, nicht nur der aktuelle Stand. Deshalb kannst du unmittelbar danach ohne Verbindung in alten Ständen nachsehen und Zweige anlegen.
Bei großen Projekten dauert das und belegt Platz. Für solche Fälle lässt sich die Geschichte beim Holen abschneiden, was den Vorgang stark verkürzt und die meisten Möglichkeiten erhält.
Was nach dem Clone noch fehlt
Alles, was nicht im Repository steht: die Abhängigkeiten, die der Paketmanager holt, die gebauten Dateien und die Konfiguration mit den Zugangsdaten.
Deshalb läuft ein frisch geklontes Projekt selten auf Anhieb. Was dann zu tun ist, gehört in die Anleitung im Repository; fehlt sie, kostet jeder neue Mitarbeiter denselben halben Tag.
Woran ein Clone scheitert
Fast immer am Zugang. Über HTTPS braucht es ein Zugangsdatum, über SSH einen hinterlegten Schlüssel; ist keins von beidem eingerichtet, bricht der Vorgang mit einer Meldung ab, die eher nach einem fehlenden Repository klingt.
Der zweite Fall sind Firmennetze, die SSH nach außen sperren. Dann bleibt der Weg über HTTPS, und das ist der Grund, warum viele Anleitungen beide Adressen nennen.